Exploiter les connaissances structurées pour améliorer la précision et la pertinence des systèmes de génération augmentée de données.
Par Ali Kore et Amrit Krishnan, Institut Vector
Contenu
- Présentation
- Aperçu de l'architecture RAG
- Mise en œuvre de la ligne de base RAG
- RAG basé sur un graphe de connaissances
- Ensemble de données et évaluation du formulaire SEC 10-Q
- Autres approches KG-RAG
- Conclusion et perspectives d'avenir
- Références
Présentation
Les systèmes de génération augmentée par la recherche (RAG) ont révolutionné la façon dont les grands modèles linguistiques (LLM) accèdent aux connaissances externes et les utilisent. En extrayant les informations pertinentes d'une base de connaissances avant de générer des réponses, les systèmes RAG permettent aux LLM de fournir des réponses plus précises, à jour et vérifiables. Comme illustré à la figure 1, un système RAG se compose de trois éléments essentiels : un extracteur qui identifie les informations pertinentes, un magasin de connaissances qui gère le référentiel de documents indexés et un générateur (généralement un LLM) qui synthétise le contexte extrait avec la requête de l'utilisateur afin de produire une réponse complète. Cependant, les systèmes RAG traditionnels rencontrent d'importantes difficultés face à des structures d'information complexes.
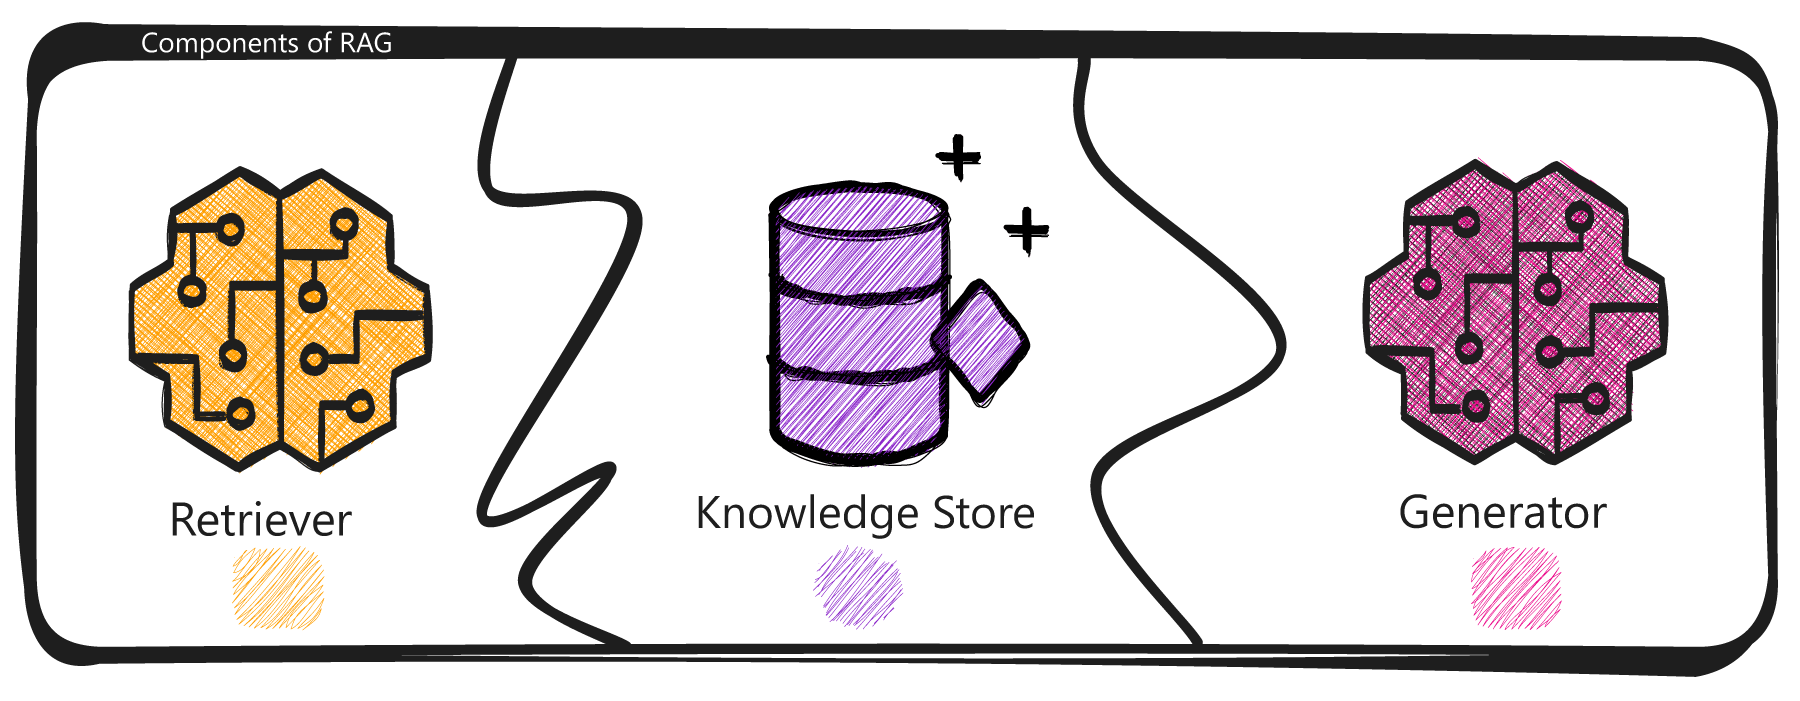
Figure 1 : Composants d’un système RAG : Récupérateur, Base de connaissances et Générateur
Les défis du RAG traditionnel
Les implémentations RAG standard reposent principalement sur la recherche de similarité vectorielle, traitant les documents comme des ensembles de segments indépendants aux relations contextuelles limitées. Bien qu'efficace pour répondre à des questions simples, cette approche présente des difficultés avec :
- Lien entre les renseignements connexes : lorsque des renseignements pertinents sont répartis dans plusieurs documents ou sections
- Comprendre les relations complexes : entre les entités mentionnées dans différents contextes
- Raisonnement en plusieurs étapes : questions nécessitant la synthèse de faits provenant de sources multiples
- Préservation des renseignements structurels : relations importantes existant dans les documents originaux
Par exemple, pour répondre à des questions sur des données financières, un système RAG traditionnel peut extraire des extraits de documents contenant des chiffres pertinents, mais risque de passer à côté d'informations cruciales concernant les périodes fiscales, les produits ou les segments d'activité auxquels ils se rapportent. Ce problème est particulièrement préoccupant pour les documents financiers normalisés comportant des sections fortement corrélées.
Graphes de connaissances : une solution structurelle
Les graphiques de connaissances offrent une solution naturelle à ces défis en modélisant explicitement les entités et leurs relations. En représentant les documents comme des nœuds et des bords interconnectés plutôt que comme des blocs isolés, les systèmes RAG basés sur les graphes de connaissances peuvent :
Figure 2 : Visualisation interactive d’un graphique de connaissances pour les données financières. Ce graphique représente des entités comme Apple Inc., ses indicateurs financiers sur différents trimestres et les relations entre elles. Cliquez sur un nœud pour explorer ses connexions.
- Identifier les relations significatives : entre les entités mentionnées dans différents documents
- Activer la récupération par parcours : suivre les chemins de connexion entre les concepts apparentés
- Combiner des informations structurelles et sémantiques : tirer parti des relations et du contenu textuel
- Aide à la recherche explicable : expliquer clairement pourquoi certaines informations ont été sélectionnées.
Les approches de RAG basées sur les graphes de connaissances ont suscité un intérêt croissant dans la recherche récente. Parmi les exemples notables, citons GraphRAG de Microsoft [2] , qui exploite les structures de graphes pour la synthèse axée sur les requêtes, ainsi que d'autres approches comme MiniRAG [3] , qui explore des méthodes de recherche efficaces combinant des fragments de texte et des entités nommées dans une structure unifiée.
Approches alternatives d'amélioration du RAG
Bien que cet article se concentre sur les améliorations apportées à RAG à l'aide de graphes de connaissances, plusieurs autres approches ont été développées pour pallier les limites de la recherche vectorielle de base :
- Filtrage par métadonnées : améliore la recherche en utilisant les métadonnées des documents (par exemple, titres, dates, auteurs) pour filtrer ou réorganiser les résultats. Cette fonctionnalité peut être particulièrement efficace lorsque les requêtes des utilisateurs incluent des éléments de métadonnées spécifiques.
- Recherche hiérarchique (du plus grand au plus petit) : met en œuvre un processus de recherche en plusieurs étapes qui identifie d’abord les documents ou sections pertinents de haut niveau avant de récupérer des extraits spécifiques à l’intérieur de ceux-ci.
- Modèles d'intégration avancés : Des modèles comme ColBERTv2 [4] et E5 [5] offrent des capacités d'intégration plus sophistiquées que les modèles de base, capturant des relations sémantiques plus nuancées. De même, la fonction Rerank de Cohere permet de réorganiser les résultats afin d'améliorer la pertinence du contexte extrait.
- Recherche hybride : combine plusieurs méthodes de recherche (par exemple, la recherche par mots-clés avec la recherche vectorielle) afin de tirer parti des forces des différentes approches.
Chacune de ces approches présente ses propres atouts et elles sont souvent complémentaires aux méthodes de graphes de connaissances. L'approche KG-RAG basée sur les entités que nous présentons dans cet article partage des similarités avec les méthodes de recherche hiérarchique : elle identifie d'abord les entités pertinentes avant d'explorer leur environnement immédiat pour trouver des fragments de documents pertinents. Cependant, elle se distingue par la modélisation et l'utilisation explicites des relations entre les entités au sein d'un graphe de connaissances structuré.
Aperçu de l'architecture RAG
Composantes clés
Comme l'illustre la figure 1, un système RAG complet se compose de trois éléments principaux qui fonctionnent ensemble pour fournir des réponses précises et contextuelles :
- Magasin de connaissances : Responsable du stockage, de l'indexation et de l'organisation des informations issues des documents sources. La base de connaissances peut être mise en œuvre selon différentes approches :
- Bases de données vectorielles (RAG traditionnelles)
- Graphes de connaissances (KG-RAG)
- Magasins hybrides (combinant plusieurs méthodes de représentation)
- Retriever : Chargé d'identifier et de récupérer les informations les plus pertinentes dans la base de connaissances en fonction de la requête de l'utilisateur. Les mécanismes de récupération varient selon la mise en œuvre :
- Similitude d'intégration (RAG traditionnel)
- Parcours du graphe (KG-RAG)
- approches hybrides combinant plusieurs stratégies de récupération
- Générateur : Modèle de langage complexe qui synthétise le contexte extrait et la requête utilisateur pour produire une réponse complète. Bien que le générateur soit généralement cohérent d'une implémentation RAG à l'autre, son efficacité dépend fortement de la qualité et de la pertinence du contexte extrait.
Dans cet article, nous nous concentrons principalement sur les composantes de stockage et de récupération des connaissances, car c'est là que les améliorations apportées au graphe de connaissances ont l'impact le plus significatif. Les sections suivantes exploreront comment ces composants sont implémentés dans l'approche RAG vectorielle traditionnelle et dans notre approche basée sur un graphe de connaissances.
Mise en œuvre de la ligne de base RAG
Flux de travail
L'approche RAG standard repose sur la similarité vectorielle entre l'intégration de la requête et les fragments de documents préintégrés dans la base de données vectorielle afin de récupérer le contexte pertinent. Cette implémentation s'aligne sur les trois composants principaux présentés dans la figure 1 : le Knowledge Store contient les emboîtements des fragments associés aux fragments de documents ; le Retriever utilise la similarité des emboîtements pour faire correspondre les requêtes aux fragments pertinents ; et le Generator est un LLM. Le processus suit un pipeline simple, comme illustré ci-dessous :
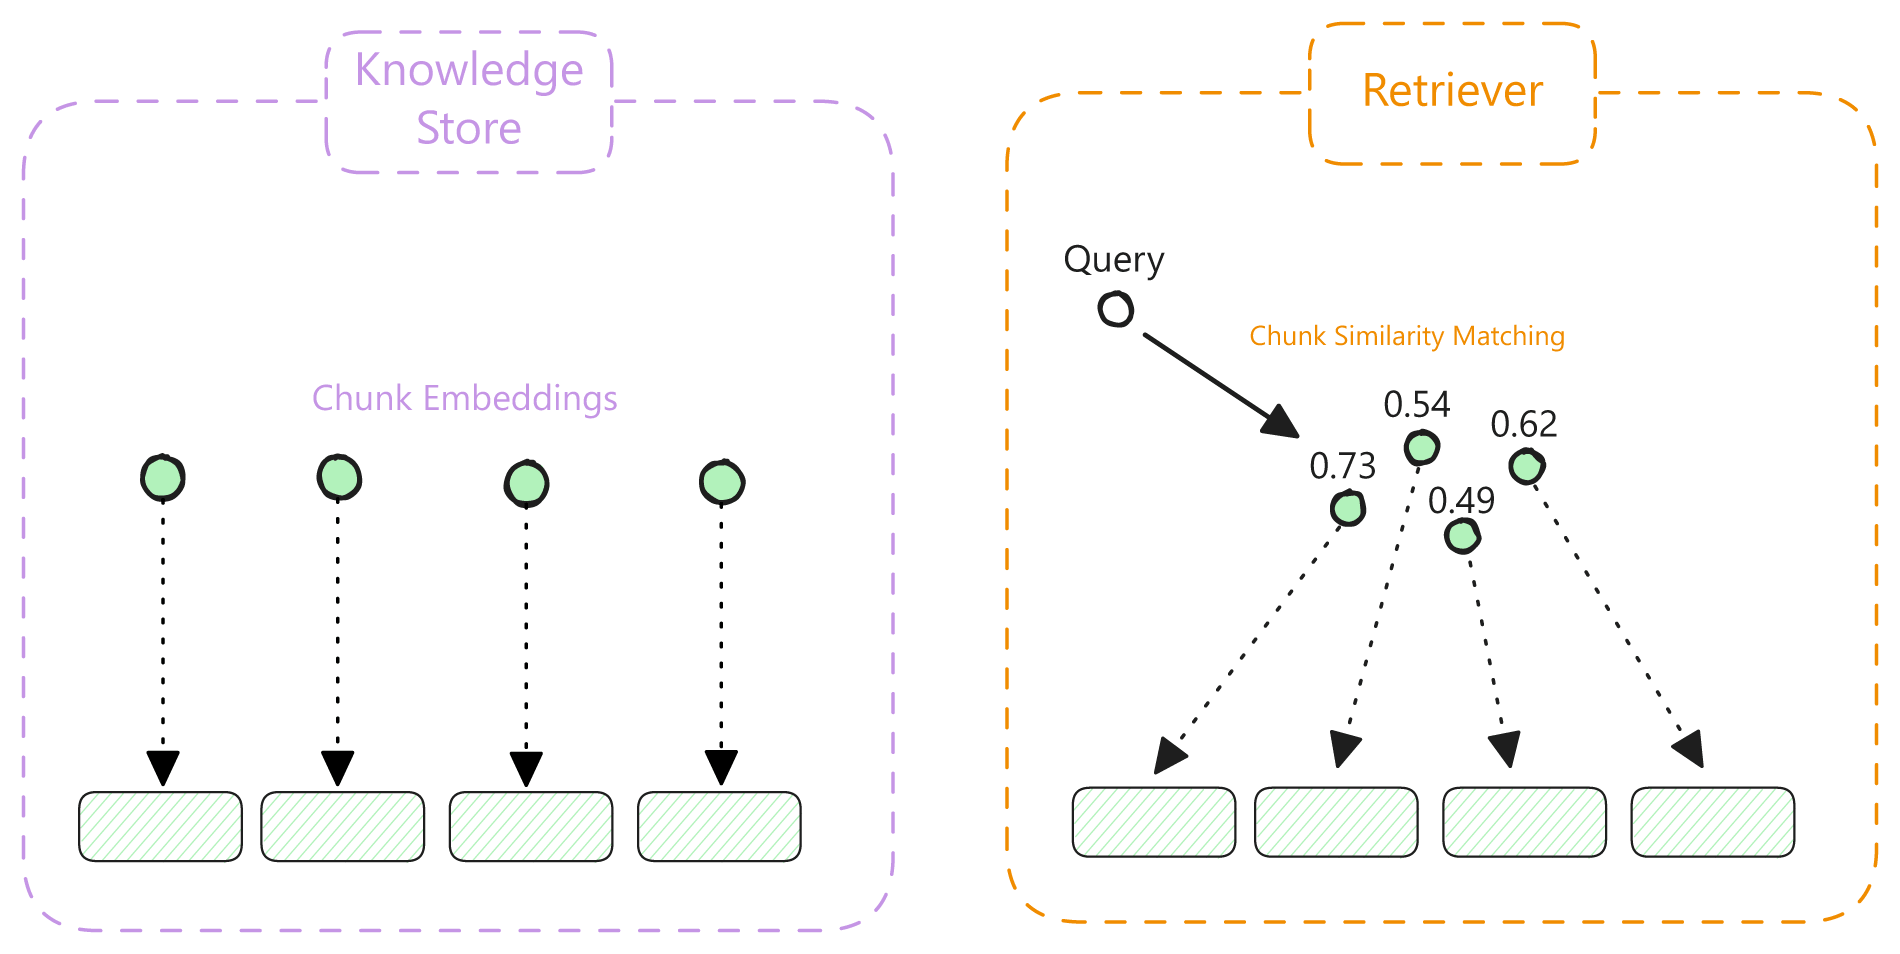
Figure 3 : Architecture RAG standard montrant le magasin de connaissances avec des plongements de blocs et le récupérateur utilisant une correspondance de similarité directe entre la requête et les blocs de documents
Le déroulement du travail consiste en trois étapes principales :
- Intégration des requêtes : Convertir la requête de l’utilisateur en un vecteur d’intégration
- Correspondance de similarité de segments : Trouvez des segments de documents dont les emboîtements sont similaires à la requête (le Retriever calcule des scores de similarité tels que 0,73, 0,54, etc.).
- Sélection de segments : Sélectionnez les k segments les plus semblables en fonction de ces scores
Dans notre implémentation du système de base, nous incorporons des métadonnées dans des blocs en ajoutant des informations de source (par exemple, « From: 2023_Q3_AAPL.pdf ») en haut de chaque bloc, bien que ces métadonnées ne soient pas incluses dans le calcul d'intégration lui-même.
Limites
Cette approche fonctionne bien pour de nombreuses tâches de réponse aux questions, mais elle présente certaines limites lorsqu'il s'agit de domaines complexes et fortement relationnels :
- Le Knowledge Store ne saisit que les correspondances directes entre les plongements lexicaux et les segments, sans préserver les relations entre les informations entre les différents segments.
- Le Retriever s'appuie uniquement sur la correspondance de similarité directe, ce qui rend difficile le traitement des questions à sauts multiples nécessitant le suivi de chaînes de relations.
- En l'absence de relations explicites entre les entités, le système a une capacité limitée à exploiter les informations structurelles présentes dans les documents originaux.
- L'approche basée uniquement sur la similarité risque de récupérer des segments sémantiquement liés à la requête, mais dépourvus des relations contextuelles spécifiques nécessaires à des réponses précises.
RAG basé sur un graphe de connaissances
Pour pallier les limites des méthodes RAG vectorielles, nous proposons des approches basées sur les graphes de connaissances qui intègrent des relations structurées au processus de recherche. Ces méthodes construisent et exploitent un graphique de connaissances représentant les entités et les relations extraites de la collection de documents.
Génération de graphiques de connaissances
L'efficacité de tout système KG-RAG dépend fortement de la qualité du graphe de connaissances sous-jacent. Mais comment ce graphe est-il généré à partir du texte non structuré d'un document ? Le processus consiste généralement à utiliser des modèles linéaires linéaires (LLM) pour extraire les entités et leurs relations à partir de segments de texte.
Extraction d'entités et de relations basée sur LLM
Le cœur de notre processus de génération de graphes de connaissances est le LLMGraphTransformer de Langchain, qui exploite de vastes modèles linguistiques pour identifier les entités et les relations dans le texte des documents. Le processus suit les étapes clés suivantes :
- Découpage du texte en segments : les documents sont d’abord divisés en segments gérables.
- Extraction des entités et des relations : chaque segment est traité par un LLM avec des instructions spécialisées.
- Construction du graphe : Les entités et relations extraites sont assemblées en une structure de graphe cohérente.
Examinons de plus près le processus d'extraction :
# Define the graph transformer with allowed entities and relationships
transformer = LLMGraphTransformer(
    llm=ChatOpenAI(model="gpt-4o", temperature=0),
    strict_mode=True
)
# Process documents to extract graph elements
graph_documents = transformer.convert_to_graph_documents(documents)
# Create a unified graph from the extracted elements
graph = create_graph_from_graph_documents(graph_documents)
Code Python pour la génération de graphiques de connaissances à l'aide de LLMGraphTransformer
Ingénierie rapide pour l'extraction de graphiques
Le système fournit au LLM des instructions précises pour identifier les entités et leurs relations. Voici une vue simplifiée du fonctionnement de l'extraction :
Information : « Apple Inc. a annoncé une marge brute de 44,3 % pour le troisième trimestre de 2023, contre 43,3 % au cours du même trimestre de 2022. »
Entités de sortie :
- « Apple Inc. » (type : Société)
- « marge brute » (type : Métrique)
- « 44,3 % » (type : Montant)
- « T3 2023 » (type : trimestre)
- « 43,3 % » (type : Montant)
- « T3 2022 » (type : trimestre)
Relations de sortie :
— (Apple Inc., données publiées concernant la marge brute)
- (marge brute, HAS_VALUE, 44,3 %)
- (44,3 %, DÉCLARÉ EN, T3 2023)
- (43,3 %, DÉCLARÉ EN, T3 2022)
- (44,3 %, COMPARABLE À, 43,3 %)
Le LLM transforme cette sortie structurée en nœuds et arêtes de graphe avec des types et des propriétés appropriés.
Défis liés à la construction de graphes de connaissances
La construction de graphiques de connaissances de haute qualité à partir de textes non structurés présente plusieurs défis :
- Résolution des entités : Le LLM doit identifier correctement quand différentes mentions font référence à la même entité (par exemple, « Apple », « Apple Inc. », « la société »).
- Précision des relations : L'extraction de relations précises entre les entités nécessite la compréhension de schémas linguistiques complexes et une connaissance approfondie du domaine.
- Cohérence du schéma : Maintenir une ontologie cohérente (types d’entités et relations) dans divers documents
- Limitations de traitement : les fenêtres de contexte LLM limitent la quantité de texte pouvant être traitée simultanément, ce qui nécessite des stratégies de segmentation des documents rigoureuses.
Notre mise en œuvre répond à certains de ces défis en :
- Normalisation des entités pour réduire les doublons (la création de graphes NetworkX effectue cette opération par défaut)
- Découpage soigné des documents en segments pour concilier préservation du contexte et efficacité du traitement
Préservation du contexte au niveau du document
L'une des principales difficultés rencontrées est l'extraction non fiable des hiérarchies et des métadonnées au niveau des documents lors de la création du graphe de connaissances. Ce problème survient car le contexte essentiel (comme les titres de documents « AAPL T3 2023 » ou « MSFT T2 2022 ») n'apparaît généralement que sur la première page ou dans le titre du document, mais se perd lors du processus de segmentation.
Pour pallier cette limite, nous avons mis en œuvre une technique de préservation du contexte qui consiste à associer les entités à leurs titres de documents sources avant de créer leurs représentations vectorielles. Par exemple, au lieu de simplement représenter « Pourcentage de marge brute » comme une entité isolée, nous représentons « Pourcentage de marge brute - AAPL, 3e trimestre 2023 » afin d'intégrer le contexte du document. Cette approche garantit que même si l'extraction au niveau des segments ne tient pas compte de la relation hiérarchique, les représentations vectorielles des entités conservent le contexte essentiel du document source.
Approche fondée sur les entités
L'approche KG-RAG basée sur les entités améliore le pipeline RAG standard en repensant les composants Knowledge Store et Retriever illustrés à la figure 1. Au lieu de simplement stocker les plongements lexicaux, le Knowledge Store est constitué d'un graphe de connaissances d'entités interconnectées, liées par des relations entité-segment qui associent ces entités aux segments de document pertinents dont elles sont extraites. Le Retriever utilise un processus en deux étapes : il identifie d'abord les entités pertinentes, puis explore leurs connexions avant de sélectionner les segments. Ce processus se déroule comme suit :
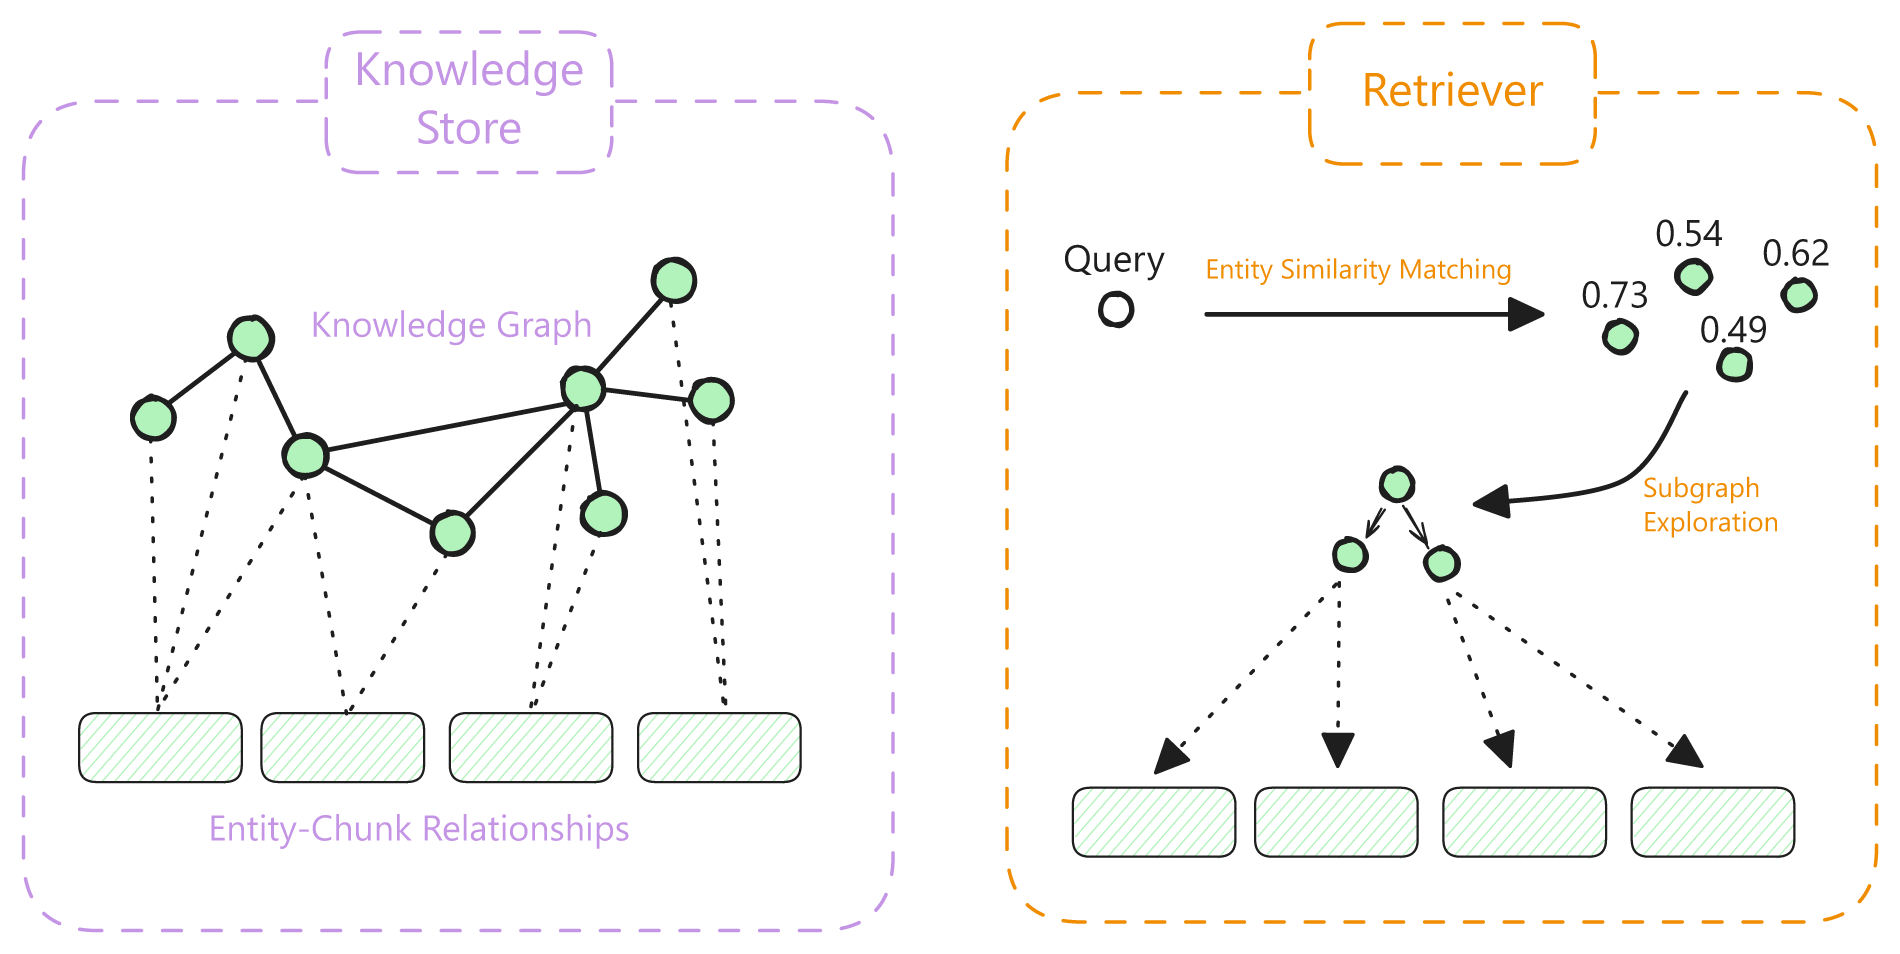
Figure 4 : Architecture KG-RAG basée sur les entités, illustrant le magasin de connaissances avec un graphe de connaissances et les relations entre entités et segments, et le module de recherche utilisant la correspondance de similarité entre entités suivie d’une exploration de sous-graphes.
Le déroulement du travail consiste en quatre étapes principales :
- Intégration des requêtes : Convertir la requête de l’utilisateur en un vecteur d’intégration
- Correspondance de similarité d'entités : trouver les N entités les plus similaires à la requête dans le graphe de connaissances (avec des scores de similarité tels que 0,73, 0,54, etc.).
- Exploration de sous-graphes : Explorez le voisinage des entités similaires pour découvrir les entités apparentées et leurs connexions.
- Vote par segment d'entité : sélectionnez les K segments de document les plus pertinents en fonction de leurs connexions et de leur similarité avec les entités identifiées et fournissez un contexte de sous-graphe.
Cette approche exploite à la fois la similarité sémantique (via les plongements lexicaux) et les relations structurelles (via le graphe de connaissances) pour fournir des réponses plus précises et complètes. Les entités du graphe de connaissances sont intégrées à partir de leur nom et du document source grâce à OpenAI. text-embedding-3-small modèle, et comparé à l'intégration de requêtes à l'aide de la similarité cosinus.
Il est important de noter que le concept de « nœuds principaux » est distinct du nombre final de segments sélectionnés. Nous choisissons les N nœuds principaux et les évaluons en fonction de leur fréquence (leur association à un segment spécifique) et de leur score de similarité global avec la requête. Nous sélectionnons ensuite les K segments les plus pertinents selon ce score combiné.
Visualisation interactive
Pour mieux comprendre le fonctionnement pratique de la méthode KG-RAG basée sur les entités, examinons une visualisation interactive du processus pour une requête où le système de base répond incorrectement, mais où le système basé sur les entités donne la bonne réponse :
Figure 5 : Visualisation interactive de l’approche KG-RAG basée sur les entités, illustrant le flux de traitement d’une requête concernant le pourcentage de marge brute d’Apple. Cette visualisation montre comment les entités sont identifiées, le sous-graphe exploré et les extraits de documents pertinents sélectionnés pour fournir des réponses complètes.
La visualisation ci-dessus montre comment une requête concernant le pourcentage de marge brute d'Apple circule dans le système KG-RAG basé sur les entités :
- Le système identifie d'abord les entités pertinentes dans le graphe de connaissances en fonction de leur similarité avec la requête.
- Il explore ensuite le sous-graphe autour de ces entités pour découvrir des informations connexes
- À partir du sous-graphe exploré, il sélectionne les segments de documents les plus pertinents.
- Finalement, il constitue un contexte global qui combine connaissances structurelles et informations textuelles.
Avantages
L'approche KG-RAG basée sur les entités offre plusieurs avantages par rapport aux systèmes RAG traditionnels :
- Préservation du contexte relationnel : la structure graphique du Knowledge Store maintient explicitement les relations entre les entités, préservant ainsi des informations contextuelles cruciales qui pourraient être perdues dans les approches vectorielles.
- Prise en charge du raisonnement multi-sauts : la capacité d’exploration de sous-graphes du Retriever permet au système de découvrir des entités et des informations pertinentes qui peuvent se trouver à plusieurs sauts des entités initialement appariées.
- Sélection du contexte basée sur les entités : les relations entité-bloc dans le Knowledge Store garantissent que les blocs de documents sont sélectionnés en fonction de leurs connexions aux entités pertinentes, et non seulement de leur similarité lexicale.
- Structures des données financières : Les documents financiers suivent des structures prévisibles, l’information étant organisée autour d’entités clés telles que les entreprises, les périodes et les indicateurs financiers. Les graphiques de connaissances saisissent naturellement ces structures, ce qui les rend particulièrement efficaces dans ce domaine.
- Explication et transparence : les chemins du graphe de connaissances expliquent clairement comment les différentes informations sont liées, ce qui améliore la transparence du processus de recherche.
Défis et limites
Malgré ses avantages, les approches RAG basées sur les graphes de connaissances font également face à plusieurs défis et limites :
- Spécificité du domaine : L'efficacité d'un graphe de connaissances dépend fortement de sa capacité à saisir les relations spécifiques au domaine présentes dans les documents. Différents domaines peuvent nécessiter différents schémas graphiques et approches d’extraction.
- Surcharge de calcul : La construction et la maintenance d’un graphe de connaissances engendrent des besoins de calcul supplémentaires par rapport aux simples bases de données vectorielles, en particulier pour les grandes collections de documents.
- Qualité du graphique et performances : La qualité du graphique des connaissances influence directement la performance du système KG-RAG. Des graphiques incomplets ou inexacts peuvent entraîner des connexions manquantes ou des résultats non pertinents.
- Défis d'optimisation : Trouver la configuration optimale pour la construction et l'exploration d'un graphe de connaissances (par exemple, les seuils de similarité, le nombre de sauts) nécessite souvent une expérimentation approfondie.
Dans notre implémentation initiale, nous avions pour objectif de créer un graphique de connaissances reliant les entités aux nœuds terminaux contenant des valeurs spécifiques (par exemple, APPLE -> HAS_DOCUMENT -> 2023 T3 -> REPORTED -> Gross Margin Percentage -> 44 %). Cependant, nous avons constaté que le processus de création du graphe privilégiait l'extraction des relations sémantiques plutôt que l'intégration de valeurs spécifiques. Cela nous a amenés à développer une approche de mappage entité-bloc comme solution pragmatique pour connecter les entités du graphe aux blocs de documents contenant les valeurs pertinentes.
Ensemble de données et évaluation du formulaire SEC 10-Q
Aperçu de l'ensemble de données
Pour évaluer les performances des différentes approches RAG, nous utilisons un ensemble de données spécialisé de Docugami, basé sur les rapports financiers trimestriels 10-Q déposés auprès de la SEC par les principales entreprises technologiques. Cet ensemble de données comprend :
- Rapports financiers d'Apple, Amazon, Intel, Microsoft et NVIDIA
- Plusieurs trimestres par entreprise (2022-2023)
- Fichiers PDF avec contenu textuel extractible
- Données financières structurées, y compris les revenus, les marges bénéficiaires et autres indicateurs.
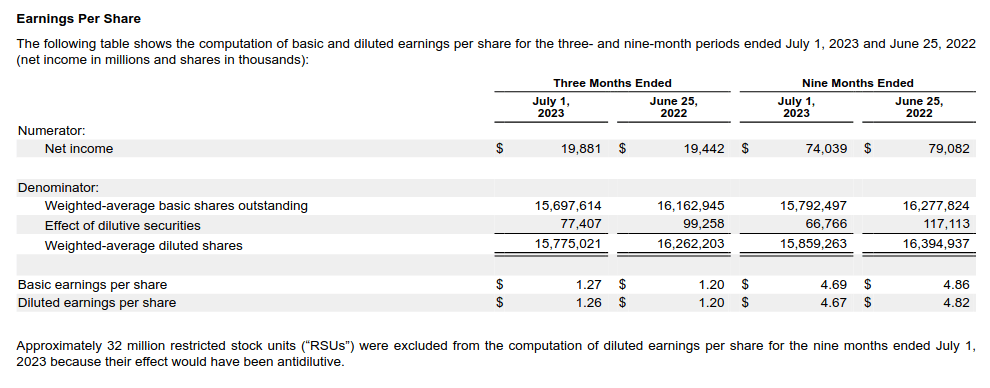
Figure 6 : Exemple de formulaire 10-Q de la SEC tiré du rapport d’Apple pour le troisième trimestre de 2023. Ce document contient des données financières structurées et des informations textuelles.
Cet ensemble de données a été choisi parce que les documents financiers représentent un cas d'utilisation idéal pour les approches par graphes de connaissances : ils contiennent de nombreuses entités avec des relations complexes entre elles, et répondre aux questions nécessite souvent de relier des informations provenant de différentes sections.
Méthodologie d'évaluation
Bien que l'ensemble de données initial comprenne des paires de questions-réponses générées par LLM et validées par des humains, celles-ci étaient généralement de nature qualitative, ce qui rendait leur évaluation précise difficile. Pour pallier cette limite, nous avons développé un ensemble de 100 paires de questions-réponses synthétiques présentant les caractéristiques suivantes :
- Dérivé des paires de questions-réponses originales, mais axé sur les réponses quantitatives
- Conçu pour fournir des réponses numériques objectives pouvant être évaluées avec précision
- Les questions nécessitent la compréhension des relations entre les entités (par exemple, les entreprises, les périodes, les indicateurs financiers).
- Vérifié manuellement pour assurer la conformité à l'aide des documents originaux
- Inclure un mélange de questions à un seul saut et de questions à sauts multiples, bien que ces dernières représentent une fraction plus petite.
Par exemple, une question qualitative comme :
« Peut-on identifier des tendances dans les revenus du segment Services d'Apple sur les périodes considérées ? »
a été transformée en une question quantitative telle que :
Quelle a été l'augmentation du chiffre d'affaires net du segment Services d'Apple entre le trimestre clos le 25 juin 2022 et le trimestre clos le 1er juillet 2023, tel que rapporté dans leurs rapports 10-Q du troisième trimestre 2022 et du troisième trimestre 2023 ? Indiquez la réponse en millions de dollars, sous forme de nombre entier sans virgule. »
Voici un exemple de question à sauts multiples où la méthode KG-RAG surpasse l'approche de référence :
Exemple de question à sauts multiples :
Quelle a été l’augmentation des dépenses de R&D d’Apple entre le troisième trimestre de 2022 et le premier trimestre de 2023, comme indiqué dans leurs rapports 10-Q du troisième trimestre de 2022 et du premier trimestre de 2023 ? Donnez la réponse en millions de dollars, sous forme de nombre entier sans virgule. »
Cette question exige du système qu'il trouve et relie des renseignements sur les dépenses de R&D provenant de deux périodes de déclaration différentes, qu'il effectue un calcul et qu'il retourne le résultat dans un format spécifique. L'approche par graphes de connaissances est particulièrement adaptée à ce type de question car elle permet de modéliser explicitement les relations entre les entités (Apple, dépenses de R&D, périodes) et de faciliter le raisonnement itératif nécessaire.
Il est important de préciser que notre choix de privilégier les questions quantitatives vise avant tout à simplifier l'évaluation et ne sous-entend pas que les utilisateurs finaux ne demanderaient que des réponses numériques. En situation réelle, les utilisateurs poseraient vraisemblablement un éventail de questions beaucoup plus large, y compris des questions qualitatives portant sur les tendances, les stratégies, les risques et d'autres informations textuelles contenues dans les rapports.
Nous avons évalué chaque système RAG en utilisant la méthodologie suivante :
- Précision : Une réponse n'est considérée comme correcte que si sa valeur numérique correspond exactement à la valeur réelle.
- Environnement contrôlé : Tous les systèmes ont utilisé les mêmes LLM (GPT-4o/GPT-4o-mini) pour la génération, garantissant que les différences de performance étaient attribuables aux composants de récupération.
- Cohérence des hyperparamètres : lorsque cela était possible, nous avons utilisé des hyperparamètres cohérents (par exemple, top-k = 5 segments) entre les systèmes afin de garantir une comparaison équitable. Pour le découpage des documents en segments, nous avons utilisé une approche standard de 512 jetons avec un chevauchement de 24 jetons, maintenue constante pour les implémentations de référence et KG-RAG.
- Analyse des erreurs : Au-delà de la simple précision, nous avons analysé la matrice de confusion entre les systèmes afin de comprendre où et pourquoi différentes approches ont réussi ou échoué.
Il est important de noter que nous n'avons mis en œuvre aucun mécanisme de réordonnancement pour les deux méthodes dans ces expériences. Cependant, le réordonnancement pourrait constituer une piste intéressante à explorer pour la méthode KG-RAG : il s'agirait de fournir des définitions de chemins de sous-graphes optimisées en termes de jetons afin que le modèle réordonne les chemins en fonction de leur pertinence pour la requête, les nœuds associés servant ensuite à sélectionner des segments.
Résultats de rendement
Notre évaluation a révélé des différences de performance significatives entre les approches RAG de base et KG-RAG basées sur les entités. La visualisation suivante présente la comparaison globale de la précision :
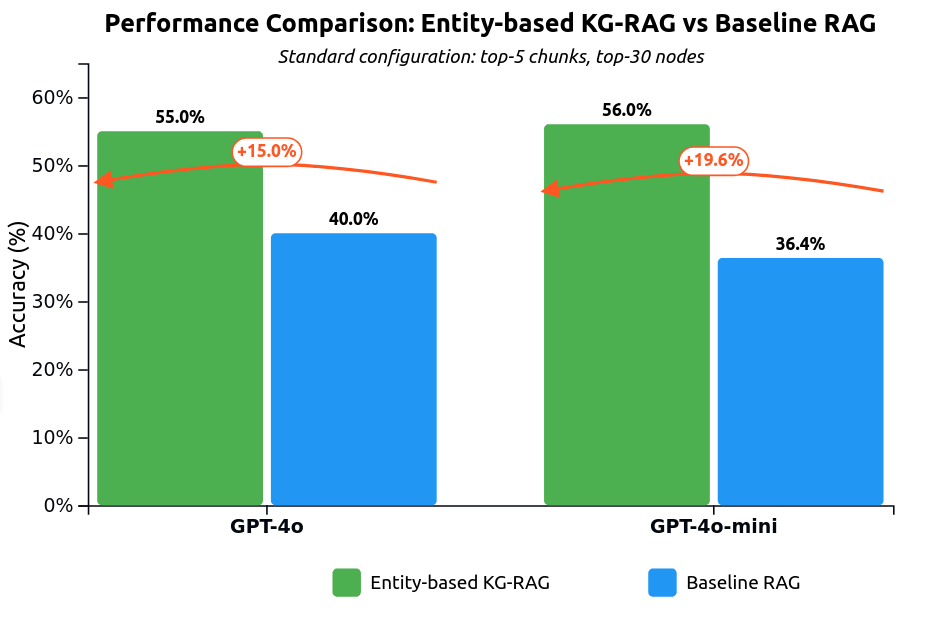
Figure 7 : Comparaison des performances entre KG-RAG basé sur les entités et RAG de référence pour différents modèles LLM. KG-RAG basé sur les entités surpasse systématiquement l'approche de référence.
L'approche KG-RAG basée sur les entités a démontré une amélioration substantielle par rapport à la méthode de référence, avec une précision passant de 40 % à 55 % avec GPT-4o et de 36,36 % à 56 % avec GPT-4o-mini. Cela représente une amélioration relative d'environ 37,5 % et 54 % respectivement.
Étonnamment, les performances de l'approche par entités étaient encore plus marquées avec le modèle GPT-4o-mini, plus petit, dont les performances sont généralement inférieures à celles du modèle GPT-4o, plus grand. Cela suggère que les connaissances structurelles fournies par le graphe de connaissances compensent les limites du modèle réduit, lui permettant d'exploiter les relations plus efficacement que l'approche de référence.
En ce qui concerne la latence, nos mesures ont montré que la méthode KG-RAG n'ajoute qu'une surcharge minimale au processus de récupération par rapport à la méthode de référence :
- Méthode de référence : Latence moyenne : 0,5679 seconde, Médiane : 0,3511 seconde
- Méthode KG-RAG : Latence moyenne : 0,6224 seconde, Médiane : 0,4533 seconde
Nous procédons ici à une analyse détaillée des erreurs à l'aide d'une matrice de confusion afin de comprendre les schémas de réussite et d'échec entre les deux approches :
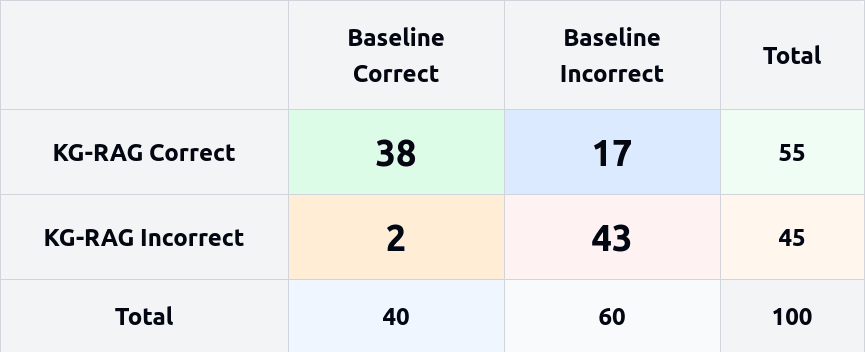
Figure 8 : Matrice de confusion comparant les performances de KG-RAG et de la méthode de référence RAG. Cette matrice montre que KG-RAG répond correctement à de nombreuses questions auxquelles la méthode de référence ne répond pas, tout en se trompant rarement sur les questions auxquelles cette dernière répond correctement.
La matrice de confusion révèle que :
- Les deux systèmes ont répondu correctement à 38 questions (38 % de l'ensemble de données).
- KG-RAG a répondu correctement à 17 questions auxquelles le RAG de référence n'a pas répondu.
- Baseline RAG a répondu correctement à seulement 2 questions auxquelles KG-RAG a échoué
- Les deux systèmes ont mal répondu à 43 questions (43 % de l'ensemble des données).
Ce schéma asymétrique suggère que l'approche KG-RAG conserve la plupart des forces de l'approche de base tout en remédiant à bon nombre de ses faiblesses grâce à une meilleure compréhension structurelle.
Nous avons également étudié comment les performances de l'approche KG-RAG varient en fonction de différents paramètres de configuration, notamment le nombre de nœuds principaux considérés lors de l'étape de correspondance de similarité :
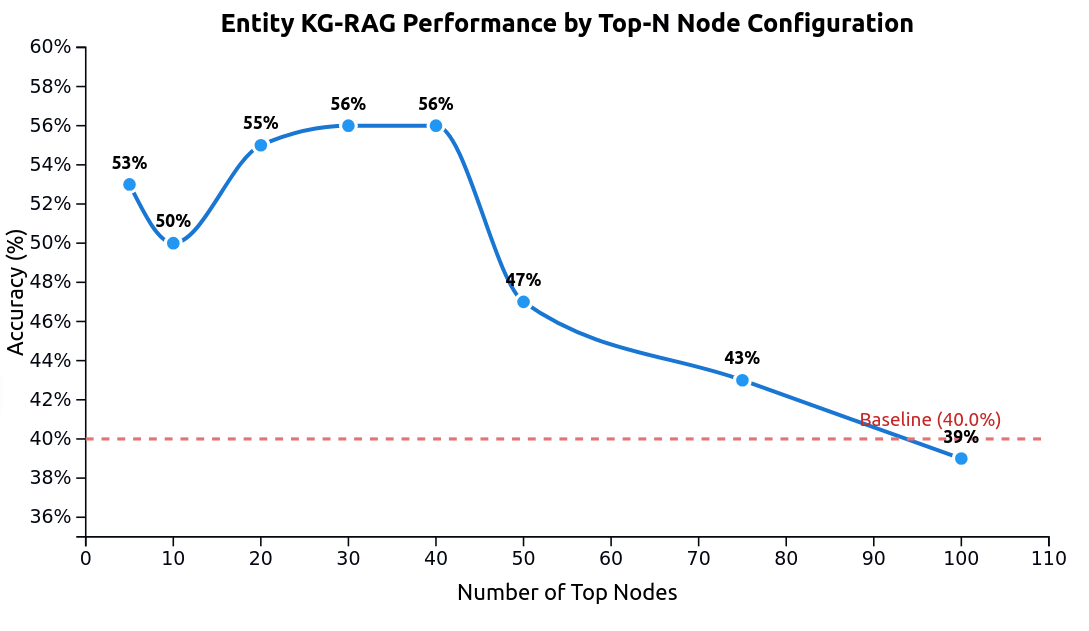
Figure 9 : Performances de KG-RAG en fonction du nombre de nœuds de similarité les plus élevés considérés. Les performances optimales sont obtenues autour de 30 à 40 nœuds ; au-delà, les gains diminuent.
This analysis reveals that performance peaks when considering between 30-40 top similar nodes (56% accuracy), with a noticeable decline when considering either too few (< 10 nodes) or too many (> 50 nodes) similar entities. This suggests an optimal balance where the system has enough similar entities to explore related connections, but not so many that it introduces noise or dilutes the relevance of the retrieved context.
Autres approches RAG pour les graphes de connaissances
Bien que cet article se soit concentré sur l'approche KG-RAG basée sur les entités, nous avons également implémenté plusieurs autres méthodes basées sur les graphes de connaissances qui s'avèrent prometteuses pour différents cas d'utilisation. Ces approches n'ont pas été incluses dans l'évaluation principale pour diverses raisons détaillées ci-dessous, mais elles offrent des alternatives intéressantes pour des scénarios spécifiques.
KG-RAG basé sur le chiffrement
La méthode KG-RAG basée sur Cypher exploite une base de données graphiques Neo4j et utilise le langage de requête structuré (Cypher) au lieu des plongements vectoriels comme principal mécanisme de récupération :
- Génération de requêtes Cypher : Un modèle d’invite LLM spécialisé permet de générer des requêtes Cypher valides à partir de questions en langage naturel.
- Conception prenant en compte le schéma : le système conserve une connaissance du schéma graphique sous-jacent afin de s'assurer que les requêtes générées utilisent les types d'entités et les relations appropriés.
- Recherche déclarative : plutôt que d’explorer un sous-graphe en fonction de la similarité, cette approche interroge directement des modèles de relations spécifiques.
- Gestion des erreurs : Comprend des mécanismes permettant de détecter et de corriger les requêtes malformées par un processus itératif
Cette approche excelle lorsque les questions correspondent clairement à des modèles de relations spécifiques dans le graphe de connaissances, mais elle exige une connaissance plus approfondie de la structure sous-jacente du graphe. On utilise les cookbooks Neo4j de Langchain comme référence pour notre implémentation. LlamaIndex implémente également un moteur de requêtes de graphes de connaissances utilisant Neo4j et la génération de données chiffrées.
Lors de nos tests initiaux, l'approche basée sur le chiffrement a rencontré des difficultés avec le graphe de connaissances fourni pour l'ensemble de données SEC 10-Q, car les requêtes Cypher générées par LLM ne parvenaient pas à saisir de manière fiable la complexité des relations dans les documents financiers. Cela a entraîné une génération instable de requêtes et des résultats incohérents, raison pour laquelle nous l'avons exclue de l'évaluation principale.
Les travaux futurs pourraient exploiter des modèles personnalisés pour la génération de chiffrements ou la validation de chiffrements en boucle afin d'affiner la requête jusqu'à l'émission d'un chiffrement valide.
GraphRAG
GraphRAG combine les graphiques de connaissances avec des algorithmes de recherche basés sur l'intégration et la détection de communautés :
- Transformation de documents en graphiques : transforme les documents en structures graphiques comportant des nœuds, des arêtes et des groupes de communautés.
- Stratégies de recherche hybrides : met en œuvre des stratégies de recherche à la fois locales (centrées sur les nœuds) et globales (basées sur la communauté).
- Détection de communautés : Utilise des algorithmes de graphes pour identifier des groupes d'informations connexes
- Intégration LangChain : Basée sur le cadre LangChain pour une intégration transparente avec d’autres composants
Cette approche est particulièrement efficace pour les documents présentant des structures communautaires naturelles, tels que les articles de recherche comportant des sections distinctes ou les rapports couvrant divers secteurs d'activité. Nous utilisons une implémentation GraphRAG de Langchain pour sa simplicité d'utilisation, bien que d'autres implémentations, comme celles de LlamaIndex, offrent également des fonctionnalités similaires.
Lors de nos premières évaluations, cette implémentation de GraphRAG a atteint une précision d'environ 20 % (sans réglage préalable) sur l'ensemble de données SEC 10-Q. Faute de temps, nous avons décidé de concentrer notre évaluation complète sur l'approche par entités, qui avait montré des résultats initiaux plus prometteurs.
Conclusion et perspectives d'avenir
Les approches RAG basées sur les graphes de connaissances représentent une avancée significative par rapport aux méthodes vectorielles traditionnelles, notamment pour les domaines aux structures relationnelles complexes. En intégrant les relations structurées au processus de recherche, ces méthodes permettent d'obtenir des réponses plus précises, complètes et explicables.
Nos expériences avec la méthode KG-RAG basée sur les entités montrent des résultats prometteurs, notamment pour les questions qui nécessitent la compréhension des relations entre plusieurs entités et documents. La possibilité d'explorer des sous-graphes et de combiner les connaissances structurelles avec les informations textuelles permet d'obtenir des réponses plus nuancées et précises.
L'analyse comparative démontre clairement que l'intégration de connaissances structurelles via des graphiques de connaissances améliore considérablement la capacité des systèmes RAG à gérer des besoins d'information complexes, notamment dans des domaines présentant des structures relationnelles riches comme la documentation financière.
Les orientations futures de cette recherche comprennent :
- Techniques améliorées de construction de graphiques : développement de meilleures méthodes d’extraction automatique d’entités et de relations à partir de documents
- Mises à jour dynamiques du graphique : Création de systèmes capables de mettre à jour en continu le graphique des connaissances à mesure que de nouvelles informations sont disponibles.
- Récupération améliorée par le raisonnement : intégration des capacités de raisonnement logique dans le processus d’exploration de graphes
- Approches hybrides : Intégration des forces des différentes méthodes KG-RAG pour une performance optimale face à divers types de questions
Le code source permettant de reproduire toutes les expériences et implémentations décrites dans cet article est disponible dans notre dépôt KG-RAG .
Remerciements
Nous tenons à remercier le Vector Institute pour son soutien à cette recherche, ainsi que la communauté à code source ouvert pour avoir fourni des outils et des cadres précieux qui ont rendu ce travail possible.
Références
- Institut Vector - Génie de l'IA. Guide de référence de poche sur l'IA , 2024. vectorinstitute.github.io/ai-pocket-reference
- Darren Edge, Ha Trinh, Newman Cheng, Joshua Bradley, Alex Chao, Apurva Mody, Steven Truitt, Dasha Metropolitansky, Robert Osazuwa Ness et Jonathan Larson. « Du local au global : une approche RAG de graphes pour la synthèse axée sur les requêtes » , 2025. arXiv:2404.16130. arxiv.org/abs/2404.16130
- Tianyu Fan, Jingyuan Wang, Xubin Ren et Chao Huang. MiniRAG : Vers une génération augmentée par récupération extrêmement simple , 2025. arXiv:2501.06713. arxiv.org/abs/2501.06713
- Keshav Santhanam, Omar Khattab, Jon Saad-Falcon, Christopher Potts et Matei Zaharia. ColBERTv2 : Recherche efficace et efficiente par interaction tardive légère , 2022. arXiv:2112.01488. arxiv.org/abs/2112.01488
- Liang Wang, Nan Yang, Xiaolong Huang, Binxing Jiao, Linjun Yang, Daxin Jiang, Rangan Majumder et Furu Wei. Incorporations de texte par préformation contrastive faiblement supervisée , 2024. arXiv : 2212.03533. arxiv.org/abs/2212.03533