Par Ali Kore, Mahshid Alinoori et Shayaan Mehdi, Institut Vector
Contenu
- Présentation
- 1. Un axe : la récupération devient agentique
- 2. Deux boutons, une frontière
- 3. Corpus, requête et contenu du substrat
- 4. Ce que comparent réellement les comparaisons publiées
- 5. Qu'arrive-t-il lorsque le graphique est mis à jour ?
- 6. Ce que change le bouton de l'agent
- 7. Ce qu'on mesurerait avant de tourner un bouton
- Références
Présentation
La génération augmentée par la recherche dispose maintenant d'un large éventail d'améliorations. Un système de reclassement, une requête décomposée, un graphe de connaissances ou un agent intégrant la recherche dans une boucle sont autant de types de modifications, chacune ayant un coût différent.
Une façon courante de classer les options est de les présenter sous forme d'échelle, en commençant par le RAG de base, puis le RAG avancé, puis éventuellement le GraphRAG, et enfin les agents. Utilisée comme procédure de décision, cette approche suggère que chaque étape représente une amélioration par rapport à la précédente. Cependant, les comparaisons publiées ne confirment généralement pas cette interprétation.
Un autre axe concerne l'importance de la recherche documentaire au sein d'une boucle de raisonnement et, séparément, ce que le substrat de recherche doit représenter. Un graphique de connaissances permet d'enrichir ce substrat. Cet article propose une première approche de ce cadre et, incidemment, aborde la question du maintien de la validité d'un graphique lorsque les documents sous-jacents sont modifiés.
1. Un axe : la récupération devient agentique
L'axe qu'on a utilisé correspond à la part de notre processus de récupération qui se déroule à l'intérieur d'une boucle de raisonnement.
Baseline RAG effectue une seule récupération et une lecture. Une requête est intégrée, les fragments les plus proches sont renvoyés, et le générateur répond. Le pipeline est statique et chaque requête suit le même chemin.
Advanced RAG améliore les résultats de cette première passe. La recherche hybride lexicale et dense, le réordonnancement inter-encodeurs, le découpage contextuel ou hiérarchique et la réécriture de requêtes améliorent la qualité de l'ensemble des candidats sans modifier le flux de contrôle.
Agentic RAG intègre une partie de la recherche dans une boucle. La décomposition de la requête divise la question avant la recherche ; les boucles de type ReAct entremêlent le raisonnement et les actions de recherche ; les approches correctives telles que CRAG évaluent les résultats obtenus et effectuent une nouvelle recherche si nécessaire.
La recherche native à l'agent élimine l'index vectoriel de la boucle. L'agent parcourt le corpus à l'aide d'appels de recherche, de fichiers et d'outils, à la manière des agents de programmation qui interagissent avec un dépôt. La recherche se résume alors aux actions effectuées par l'agent.
Nous considérons ces éléments comme des positions sur une colonne vertébrale. Un pipeline statique reposant sur un index bien structuré constitue un point d'ancrage raisonnable. Se déplacer le long de cet axe implique de privilégier la latence, le coût des jetons et la variance au détriment de l'adaptabilité.
2. Deux boutons, une frontière
La colonne vertébrale est plus facile à manipuler à côté d'une deuxième image. Deux cercles se chevauchent : la récupération, le substrat sur lequel un système peut s'appuyer, et l'agent, la boucle qui raisonne à partir de ce substrat. En se déplaçant le long de la colonne vertébrale, le cercle de l'agent s'agrandit jusqu'à ce que, à l'extrémité agent-natif, les deux coïncident.
Figure 1. Déplacez le cercle de l'agent sur la zone de récupération et définissez son étendue. Le chevauchement représente la quantité de récupération effectuée à l'intérieur de la boucle. Les quatre positions indiquées correspondent à des mesures de ce chevauchement, et non à des points d'arrêt fixes.
L'hypothèse de travail est que la qualité peut être modulée en ajustant l'un ou l'autre paramètre. Un substrat riche avec une boucle simple et un substrat basique avec une boucle sophistiquée peuvent aboutir à une qualité de réponse similaire, mais avec des coûts, une latence et un fonctionnement très différents.
Chaque paramètre a ses propres réglages. Le paramètre « substrat » détermine la représentation du corpus : segments plats, segments hiérarchiques ou contextuels, index lexical et dense hybride, ou graphe de connaissances. Tous ces éléments sont construits avant même qu'une question ne soit posée.
Le paramètre « agent » détermine ce que l'agent fait avec le substrat. Une extrémité correspond à une seule action : aucune boucle, récupération unique et génération. La décomposition de la requête divise la question et récupère les données par partie. Une boucle de type ReAct entrelace le raisonnement et les actions de récupération, et détermine l'action suivante en fonction du résultat précédent. L'autocritique ajoute une étape d'évaluation en notant ses propres preuves ou réponses et en réessayant en cas d'échec ; c'est le modèle que formalisent CRAG et Self-RAG.
Chacune de ces architectures est différente, avec son propre profil de latence et ses propres modes de défaillance.
Le réordonnancement n'est pas directement lié à l'interface. Il s'agit d'une étape supplémentaire qui s'ajoute aux données renvoyées par le substrat, ce qui explique pourquoi la construction d'un graphique et d'un réordonnanceur est une approche courante. Un graphique de connaissances avec parcours basique et un index de blocs plat avec un agent performant sont deux architectures où la complexité relative se situe à l'une ou l'autre extrémité.
Figure 2. En zoomant sur la zone de chevauchement, on distingue deux axes : la représentation du corpus et son traitement par l’agent. Modifier l’un n’affecte pas l’autre. C'est en ajustant un paramètre à la fois qu'on obtient un gain attribuable.
Si les deux décisions convergent vers une même hiérarchie, l'infrastructure coûteuse (comme un graphe de connaissances) est plus facile à acquérir en premier, car elle se situe plus haut dans la hiérarchie envisagée. Lorsque l'évaluation s'avère insuffisante, modifier un élément à la fois facilite la recherche de la cause profonde.
3. Corpus, requête et contenu du substrat
Une deuxième coupe, orthogonale à la colonne vertébrale, correspond à ce que le substrat doit représenter. Deux propriétés permettent d'établir une première carte approximative.
La structure d'un corpus varie de lâche à dense. Un corpus lâche contient des documents narratifs ou hétérogènes présentant des relations éparses et instables entre les entités. Un corpus dense, quant à lui, comporte des entités récurrentes, une hiérarchie pertinente et des relations qui conservent leur sens d'un document à l'autre. Les tickets d'assistance comportant les champs « produit », « panne » et « résolution » sont plus denses qu'un ensemble de dissertations sans lien apparent.
Les types de requêtes varient, allant de la recherche de faits locaux à un raisonnement complexe basé sur les relations. Les requêtes locales nécessitent un ou deux passages. Les requêtes multi-sauts combinent des faits provenant de différentes sources. Les requêtes globales portent sur les thèmes ou la couverture d'un corpus entier. Les requêtes de chemin demandent la chaîne de relations elle-même, le chemin faisant alors partie intégrante de la réponse.
Figure 3. Première représentation de la structure du corpus en fonction du type de requête, déduite des résultats publiés au niveau de la tâche. Les contraintes opérationnelles peuvent déplacer une cellule.
Pour les requêtes factuelles locales sur un corpus peu structuré, une architecture de recherche optimisée est souvent suffisante. L'extraction de graphiques peut ajouter des relations parasites sans pour autant apporter à la requête les fonctionnalités nécessaires. Sur un corpus dense, les filtres de métadonnées et d'entités saisissent parfois une structure suffisante pour les questions locales, rendant ainsi l'ajout d'un graphe prématuré.
Le recours au multi-saut est plus délicat. La décomposition des requêtes et les boucles itératives de récupération-analyse-récupération fonctionnent sans graphe persistant. Les méthodes graphiques semblent plus plausibles lorsque les mêmes relations se répètent dans le trafic et que le corpus est suffisamment stable pour que la construction puisse s'amortir. C'est un pari risqué.
L'interprétation globale représente une charge de travail différente. Les résumés hiérarchiques peuvent couvrir un corpus peu structuré. GraphRAG, basé sur la communauté, est intéressant lorsque le corpus soutient des communautés stables et que les utilisateurs posent régulièrement des questions à l'échelle du corpus. Les requêtes de chemin explicites constituent la motivation la plus claire pour un graphe que nous connaissions, car le chemin de relation fait partie intégrante de la réponse.
La grille sert de point de départ. La taille du corpus, la fréquence de mise à jour, la latence autorisée, la variété des requêtes et l'expérience de l'équipe avec la gestion de graphes permettent de déplacer une cellule. Une méthode efficace sur un critère donné peut s'avérer inadéquate si son index est reconstruit quotidiennement ou si son chemin d'exécution excède la latence autorisée.
4. Ce que comparent réellement les comparaisons publiées
Les classements agrégés aplatissent le comportement conditionnel. Les comparaisons publiées montrent de petits écarts sur certaines tâches multi-sauts standard et de grands renversements sur des types de requêtes particuliers [1] , [2] .
| Tâche et métrique | Ligne de base de récupération | Méthode des graphiques | Différence |
|---|---|---|---|
| Rappel MuSiQue@5 | NV-Embed-v2 : 69.7 | HippoRAG 2 : 74,7 | Graphique +5.0 |
| Rappel 2Wiki@5 | NV-Embed-v2 : 76.5 | HippoRAG 2 : 90,4 | Graphique +13,9 |
| Rappel HotpotQA@5 | NV-Embed-v2 : 94.5 | HippoRAG 2 : 96,3 | Graphique +1,8 |
| Questions naturelles F1 | Vecteur RAG : 68,18 | Community-GraphRAG Local : 65,44 | RAG +2,74 |
| MultiHop-RAG temporel | RAG : 25,73 | Communauté-GraphRAG Local : 49,06 | Graphique +23,33 |
| MultiHop-RAG nul | RAG : 91,36 | GraphRAG Global : 13,95 | RAG +77,41 |
Tableau 1. Sélection de comparaisons publiées sur différents ensembles de données et métriques. Les lignes « Recall@5 » proviennent de HippoRAG 2 [3] ; Les lignes « Questions naturelles » et « MultiHop-RAG » proviennent de l’évaluation RAG versus GraphRAG [2] , dont les configurations GraphRAG suivent celles d’Edge et al. [4] . Les lignes utilisent des tâches et des systèmes de notation différents ; elles ne constituent donc pas un classement unique.
Cette incomparabilité est utile. Sur les questions temporelles MultiHop-RAG, le résultat du graphe de communauté locale a surpassé celui de RAG de 23,33 points. Sur les questions nulles, où la bonne réponse est l'absence de la réponse, Global GraphRAG a obtenu un score de 13,95 contre 91,36 pour RAG. Une réponse obtenue par réduction de carte à partir de résumés de communautés peut produire une synthèse fiable même lorsque la source ne contient pas la réponse.
Xiang et al. [1] rapportent la même dépendance à la tâche et à la structure du corpus. Leurs tests portent sur des romans à structure peu structurée et des recommandations en oncologie à structure dense. RAG avec un réordonnanceur a obtenu de meilleurs résultats que les variantes graphiques pour la recherche de faits de niveau 1 sur le corpus de romans. Les méthodes graphiques ont amélioré le raisonnement et la synthèse des niveaux 2 et 3 sur le corpus dense. L'article mentionne également une augmentation substantielle du nombre de jetons d'invite pour certaines configurations globales de GraphRAG.
Un ensemble de données de référence reflétant cette réalité inclurait des requêtes locales, multi-sauts, temporelles, globales et sans réponse, dans des proportions correspondant au trafic attendu, et enregistrerait la qualité de la recherche, l'exactitude des réponses, la latence, le coût d'indexation et le coût de mise à jour. Peu de tableaux publiés offrent une telle analyse.
5. Qu'arrive-t-il lorsque le graphique est mis à jour ?
Un index vectoriel intègre un document révisé en réinsérant les segments modifiés. Un graphique n'a aucune opération équivalente aussi peu coûteuse [5] . Puisque l'extraction est probabiliste, une mise à jour peut modifier la topologie sans altérer l'accès à l'index. L'échec, lorsqu'il survient, se manifeste par une réponse erronée malgré un chemin probable.
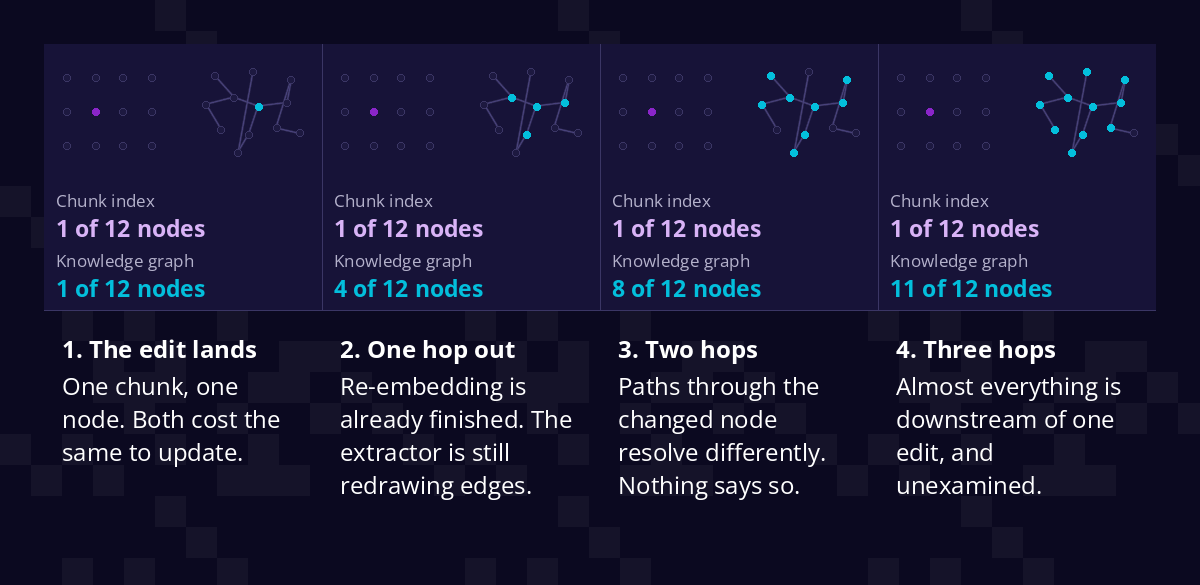
Figure 4. Modification d'un document. Dans un index de blocs, la modification demeure à son emplacement initial. Dans un graphique, elle se propage le long des bords tracés par l'extracteur, et les nœuds atteints ne sont jamais examinés.
On peut énumérer au moins trois manières principales dont cela se produit, bien qu'il y en ait probablement davantage.
Régression structurelle : la réintégration d’une page modifiée peut orpheliner un nœud, créer un artefact de concentrateur ou supprimer les arêtes qui maintiennent la cohérence d’un arbre de défaillance. L'API de requête du graphe est toujours disponible. Un paramètre qui appartenait auparavant à un chemin est maintenant isolé.
Dérive sémantique : Le typage des entités, le vocabulaire des relations et les coréférences changent entre les exécutions d'ingestion. Le même objet apparaît deux fois sous deux étiquettes différentes. Une relation qui était triggers le mois dernier related_to Ce mois-ci. Traversal est toujours en ligne. Il suit le mauvais nom.
Lacunes dans l'exhaustivité : le graphique peut être connecté sans inclure l'identifiant, la condition de déclenchement ou la résolution justifiant le chemin. Une erreur est liée à une procédure et non au paramètre qui la provoque. La pertinence de la réponse de la semaine dernière ne sera évaluée que lorsqu'une question semblable sera posée.
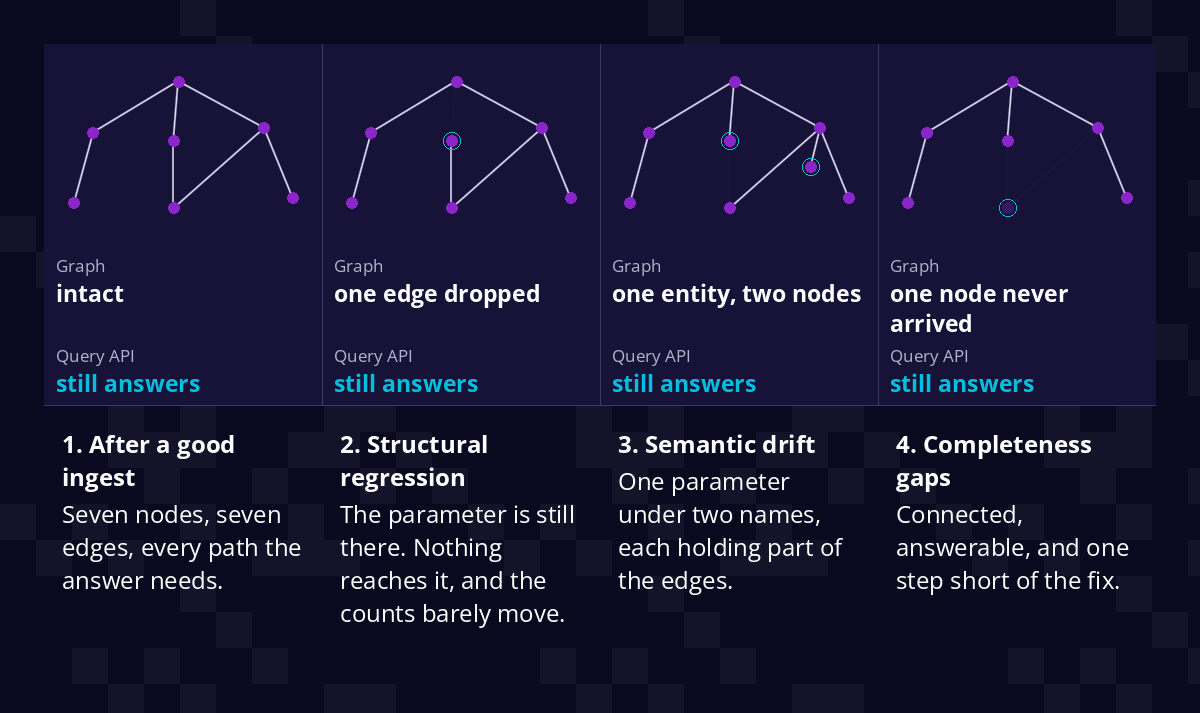
Figure 5. Un graphique de support, trois façons dont une ingestion peut l'endommager. Dans chaque cas, le graphique conserve une API de requête et son parcours retourne toujours un chemin.
L'évaluation au niveau des réponses attribue un pointage à la dernière série de questions. Elle n'examine pas le graphique qui servira à la suivante.
Figure 6. Le graphique est présenté à plat, chaque mesure représentant l'altitude. La surface pivote automatiquement et alterne entre les trois ; le curseur l'incline et met en évidence la crête sous le pointeur.
L'une des architectures que nous avons testées comporte trois niveaux superposés au graphe lui-même, ordonnés du moins coûteux et déterministe au plus coûteux et génératif.
Les cartes topologiques peuvent signaler l'isolement, l'asymétrie des degrés et l'effondrement des types de relations, et marquer les zones hautes et basses qui méritent d'être examinées.
Les formes des contraintes sont induites à partir d'un instantané considéré comme valide et servent d'empreinte digitale. Par construction, elles sont silencieuses sur cet instantané ; ainsi, toute nouvelle violation après une ingestion est une régression potentielle.
Une troisième passe initialise un modèle linéaire à long terme (LLM) sur ces zones et propose une action : fusionner une entité scindée, scinder un hub effondré, enrichir une entité orpheline ou supprimer un pont problématique. Les deltas déterministes et les éléments à examiner sont plus faciles à vérifier lorsqu'ils restent étiquetés séparément.
Un instantané validé peut être versionné de la même manière qu'un schéma. Une mise à jour (manuel révisé, nouvel article, page retirée) pourrait être soumise à un processus de validation avant d'être accessible : modification de la topologie, modification des contraintes et test préliminaire sur un petit échantillon. Les résultats seraient présentés sous forme de recommandations. Un intervenant humain pourrait approuver la fusion, la division ou l'enrichissement. Le nouveau graphique ne deviendrait l'instantané validé qu'une fois ce processus de validation terminé, et son empreinte numérique serait alors réactivée.
Deux méthodes semblent assez peu coûteuses pour être testées avant même de présenter un graphique aux utilisateurs :
L'une est une configuration synthétique où nous ajoutons, modifions et retirons des documents intentionnellement et observons si le système se déclenche suite à la défaillance que vous avez provoquée.
L'autre est un déclencheur écrit. Le choix des événements qui entraînent une réingestion (une révision de document, une modification de schéma, un seuil de dérive du vocabulaire relationnel) est un élément important à prendre en compte, ce qui reflète la manière dont les tables d'intégration plates sont mises à jour de manière sélective.
Cela représente une part importante du coût du paramètre de substrat. Sur un corpus dense et à évolution lente, cette option semble envisageable. En revanche, sur un corpus en constante évolution, il est préférable de ne pas construire le graphe et de concentrer les efforts sur l'autre paramètre.
6. Ce que change le bouton de l'agent
Tourner l'autre bouton déplace le travail de l'index vers le chemin de requête.
Un agent simple peut décomposer une question, acheminer les sous-questions locales vers une recherche hybride et n'utiliser le parcours de graphe que pour les étapes complexes impliquant de nombreuses relations. Un agent de type ReAct entrelace chaque action de récupération avec une étape de raisonnement sur le résultat de la précédente. Une boucle corrective, de type CRAG, évalue les données récupérées et relance la récupération si nécessaire. Un agent orienté graphique peut explorer les chemins potentiels, suivre les bords de soutien, revenir aux segments sources et s'arrêter lorsque les données semblent incomplètes. Un système natif d'agents navigue dans un corpus structuré à l'aide d'outils de recherche et de documentation, sans aucun index vectoriel.
Dans chaque cas, le substrat constitue une entrée d'une politique. Le contrôle agentiel ne corrigera pas un graphique bruité, et un graphique détaillé ne permettra pas de déterminer si le trajet justifie sa latence. Une comparaison entre ces deux aspects serait difficilement interprétable. Une méthode pour les distinguer consiste à exécuter les mêmes questions avec un générateur fixe, à enregistrer chaque action de récupération et à comparer les preuves fournies jusqu'à l'étape de la réponse, et non seulement le texte final.
7. Ce qu'on mesurerait avant de tourner un bouton
Les questions qui nous reviennent sans cesse, avant de modifier une architecture, sont des questions ordinaires.
Lorsqu'une question échoue, le passage approprié était-il absent de l'ensemble des candidats, ou a-t-il été récupéré mais non utilisé ?
En l'absence de preuves, la recherche hybride, le réordonnancement et un meilleur découpage en segments constituent les premières étapes les plus simples. Si les preuves sont présentes et qu'une seule passe ne permet pas de les rassembler, la décomposition et la recherche itérative sont les étapes suivantes que nous tenterons.
Un graphique entre en jeu lorsque des chemins explicites, l'agrégation d'entités ou une structure globale du corpus restent nécessaires, et seulement si le corpus est suffisamment dense et stable. Les coûts de construction, de requête et de mise à jour doivent être pris en compte au même titre que la qualité des réponses.
Références
- Zhishang Xiang et al. Quand utiliser des graphiques dans RAG : une analyse complète pour la génération augmentée par la recherche de graphes , révision 2026. arXiv:2506.05690. arxiv.org/abs/2506.05690
- Haoyu Han et coll. RAG contre GraphRAG : une évaluation systématique et des renseignements clés , révision 2026. arXiv :2502.11371. arxiv.org/abs/2502.11371
- Bernal Jimenez Gutierrez et al. De RAG à la mémoire : apprentissage continu non paramétrique pour les grands modèles de langage , ICML 2025. arXiv:2502.14802. arxiv.org/abs/2502.14802
- Darren Edge et al. « Du local au global : une approche RAG de graphes pour la synthèse axée sur les requêtes » , 2024. arXiv:2404.16130. arxiv.org/abs/2404.16130
- Vector Institute. Code source de KG-RAG et implémentation de l'article original , 2025. github.com/VectorInstitute/kg-rag